Comme nous l’avons vu dans un précédent article, il existe une librairie nommée Testcontainers qui permet de lancer des containers Docker afin de simuler des dépendances à une application. Elle simplifie énormément les tests d’intégration (ex : tester les requêtes SQL, cache Redis…) en s’intégrant parfaitement dans notre code de tests. On l’utilise beaucoup chez mon client actuel pour étendre le champ d’application des tests d’acceptance. C’est particulièrement efficace pour tester nos adapters de base de données en utilisant Fluent Migrator pour créer sans heurt le schéma de la base.
Mais Testcontainers n’est pas sans inconvénients. L’un d’eux est celui des performances : lancer un container vers une grosse dépendance est coûteux. Par le passé j’ai voulu l’utiliser avec une image SQL Server ; le lancement ainsi que la restauration du schéma (de taille conséquente) prenait plus de 15 secondes. Et dans le cas d’une image PostgreSQL, rien que lancer le serveur prend entre 3 et 5 secondes sur mon laptop. En soi ce n’est pas grave mais il n’est pas envisageable de faire tourner beaucoup de tests ainsi. Pourtant, avec mon équipe actuelle, on fait tourner plus de 300 tests avec Testcontainers en environ 1 minute (1 minute 20 sur l’agent de build). Dans cet article, je vais détailler comment optimiser le lancement de tests avec Testcontainers.
Cas d’exemple
Reprenons tout d’abord le cas de l’article précédent mais avec plus de tests. Pour rappel, dans la classe IntegrationTests, on injecte le container de base de données sous forme de ClassFixture. Cela permet de ne créer qu’un seul container pour tous les tests de la classe, ce qui « ventile » le temps de lancement du container sur tous les tests.
Isolation
Mais comment faire si on a des tests qui sont mal isolés ? Par exemple un test fait de la lecture mais avec insertion préalable de données en base. Un autre test fait de l’écriture pour terminer par un SELECT pour vérifier que l’écriture s’est bien passée, etc… toute action d’écriture aura potentiellement un impact sur les autres tests.
Par exemple, si on lance les tests tous ensemble sur cette nouvelle branche, il y aura très probablement des erreurs puisqu’un test supprime des données, nu autre en ajoute, un autre s’assure qu’il y a bien 7 livres en base, etc… Si on les lance un par un manuellement, pas de problème hormis un processus long et laborieux. Pour une isolation parfaite, il faudrait alors créer un container par test mais on en revient au problème soulevé en introduction : le temps de traitement. Donc comment faire pour à la fois isoler les tests en mutualisant les ressources ?
Première possibilité : découper par classe de test.
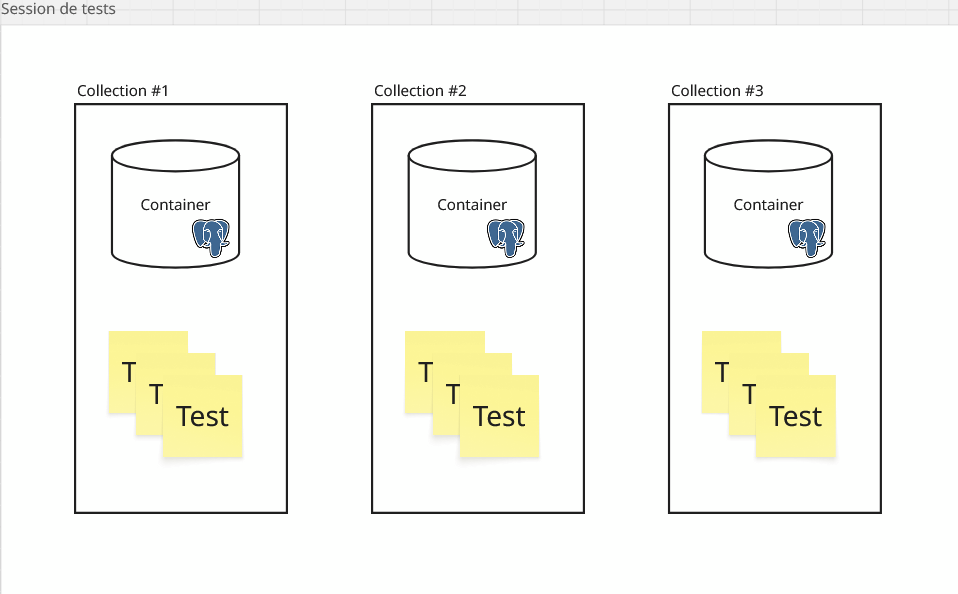
Puisqu’on crée 1 container par classe de test, si on sépare les tests de lecture et les tests d’écriture dans des classes, on devrait s’en sortir. C’est ce que j’ai fait dans cette branche : une classe pour les tests de création, une pour les tests de mise à jour et une pour les tests de lecture. Et effectivement, si on lance les tests d’un bloc, tout fonctionne.
Le découpage reste technique donc peut-être un peu artificiel en fonction du contexte métier.
D’un point de vue performances, on n’est pas si mal. En effet, le modèle de parallélisation de xUnit fonctionne par collection de tests, ce qui par défaut signifie : 1 classe de test = 1 collection = 1 thread. Chaque test à l’intérieur de chaque collection tournera ensuite de façon séquentielle. Dans notre cas, on a 3 classes et donc on aura 3 threads. Chacun aura son container dédié et personne ne se marchera sur les pieds. Et comme chaque collection tourne en parallèle des 2 autres, les containers seront créés en même temps donc on n’est pas si mal : 4.6 secondes en moyenne (commande : dotnet test -l:"console;verbosity=normal" --no-build) pour lancer tous les tests sur mon PC personnel.
Si on fait un petit bilan des avantages et des inconvénients, on a du côté des avantages :
- Isolation correcte : chaque type de test n’impacte que son container (voire pas du tout dans le cas des tests de lecture) et, si chaque test cleane un peu son contexte en fin d’exécution et grâce à la sérialisation côté TUnit, tout se passera correctement.
- Facilité de mise en oeuvre, peu de plomberie technique.
- Performances acceptables du point de vue du temps d’exécution des tests.
En revanche, au niveau des inconvénients :
- Il ne faut pas se tromper sur le découpage et bien identifier les conditions en amont.
- Le découpage reste technique donc peut-être un peu artificiel en fonction du contexte métier.
- Il peut vite y avoir beaucoup de classes de test.
- En conséquence, il peut y avoir des classes de test un peu vides et donc créer un container pour juste 1 ou 2 tests c’est pas très rentable.
- Quoi qu’il en soit, si on fait tourner plusieurs tests d’écriture au sein d’une même classe, ce dispositif ne nous exonère pas de supprimer les données de test en fin d’exécution sinon cela peut avoir des conséquences selon ce que fait le test (ex : écriture de doublon).
- Création d’un container par collection de tests, donc il peut y avoir une empreinte mémoire non négligeable. Et donc il faut attendre que le container soit créé pour qu’une collection lance les tests.
Deuxième possibilité : suppression automatique des données de tests
Ça fait plusieurs fois que je mentionne le fait que, dans une instance de base de données partagée, il faut penser à supprimer les données insérées pour les besoins du test. Mais idéalement, il faudrait pouvoir le faire automatiquement. En fait, quand on réfléchit un peu, il pourrait être souhaitable de faire tout ça à l’intérieur d’une transaction qui serait rollbackée en fin de test.
Si on teste du code où la connexion est injectée avec une WebApplicationFactory, c’est inapplicable.
Donc on pense rapidement à l’utilisation d’un TransactionScope et en parcourant le code des exemples de xUnit, je suis tombé sur un attribut fort utile. Donc j’ai recopié cet attribut dans une branche dédiée et j’ai lancé les tests plusieurs fois d’affilée. Ils fonctionnent tous et c’est bien normal puisqu’aucune transaction n’est committée, et les performances sont au rendez-vous : 3.27 secondes en moyenne sur mon PC personnel.
(Note : il existe une librairie, Respawn, qui permet de faire un peu la même chose que l’attribut custom ; cet article (en anglais), très bien fait, montre exactement l’utilisation avec Testcontainers donc je ne m’étendrai pas dessus et vous y renvoie).
Attention toutefois aux risques : si TransactionScope échoue ou si le code de prod crée ses propres connexions ou en duplique, les tests vont quand même modifier l’état de la base et ce silencieusement. Idem si le code utilise plusieurs bases de données : TransactionScope se limite à 1 transaction et donc 1 seule base de données.
Si on refait un petit bilan, on note au rayon des avantages :
- Risque complètement encadré puisque toute opération SQL est contenue dans une transaction qui ne sera jamais committée. Les tests sont donc en isolation complète les uns des autres.
- Création et lancement d’un seul container donc on ne paiera le prix qu’une seule fois. Le découpage des tests redevient libre mais attention toutefois au modèle de xUnit ; on y reviendra dans le paragraphe suivant.
- Performances, liées au point précédent.
Et pour les inconvénients :
- Demande de meilleures connaissances techniques concernant le fonctionnement du TransactionScope mais ça reste très abordable.
- Il faut pouvoir avoir la même connexion SQL entre le code de tests et le code de prod. Ça a l’air simple dit comme ça mais si on teste du code où la connexion est injectée autrement comme par exemple avec une WebApplicationFactory, c’est inapplicable.
- En cas de problème, la transaction passe et les données sont insérées, ce qui peut avoir un impact non négligeable (on retombe dans le cas de l’introduction) surtout si on tape sur une vraie instance de DB et pas un container de test.
Troisième possibilité : 1 seul container mais 1 base de données par test.
Justement, dans mon équipe actuelle, on utilise des tests gros grain basés autour de la WebApplicationFactory. Donc récupérer puis utiliser la connexion SQL injectée lors de la création de l’API est pénible, pour ensuite encadrer le tout dans un TransactionScope n’est pas idéal.
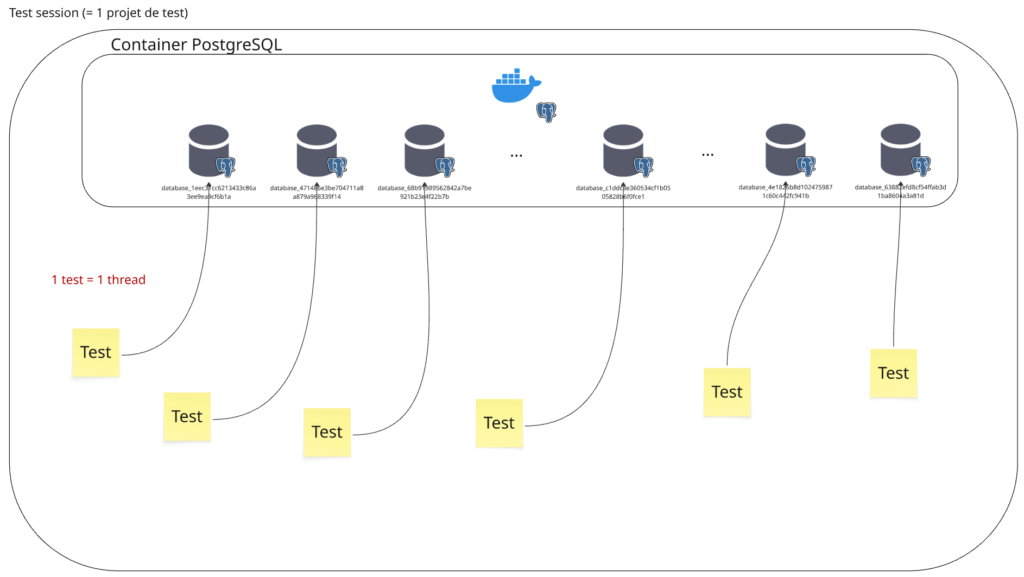
Chaque test est complètement indépendant et isolé sur sa propre base
En fait, ce qui est long, c’est de créer le container. Mais créer une base de données n’est pas très coûteux. C’est ce qu’on fait sur cette branche de code :
- La classe TestcontainersFixture contient maintenant une méthode
CreateDatabase()qui permet de créer une base de données dans le container, et une méthodeGetConnectionString(). - C’est utilisé dans les tests d’intégration : lors de l’initialisation de chaque test,
CreateDatabase()est appelée avec un nom de la base de données contenant un GUID, assurant un nom unique. - Chaque test appelle ensuite GetConnectionString() pour instancier l’adapter.
Chaque test a alors sa propre base de données dédiée, ce qui permet une meilleure isolation puisque seul le serveur de base de données est partagé.
Au niveau des performances, on tourne aux alentours de 4.4 secondes sur ma machine. De plus, comme on ne paie le coût de création du container qu’une fois, chaque nouveau test ajouté fera automatiquement baisser la moyenne de temps de run par test.
Avantages :
- Chaque test est complètement indépendant et isolé sur sa propre base, aucun effet de bord avec les autres tests.
- Un seul container : peu importe qu’on ait 2 tests ou 100, le temps de création du container n’est payé qu’une seule fois.
- On peut paralléliser complètement l’exécution des tests. Mais on en reparle juste après.
Inconvénients :
- Peut être pénible à mettre en place techniquement : dans un cas simple ça va mais il faut pouvoir initialiser chaque base avec le bon schéma de base de données. C’est ici que des solutions comme Fluent Migrator peuvent être extrêmement intéressantes.
- La création de la base dans chaque test peut prendre un peu de temps, ce qui s’ajoute avec le reste.
Lancer tous les tests en parallèle ?
Si on reprend ce qu’on vient de dire avec la 3ème possibilité, chaque test étant indépendant, on peut se permettre de tout lancer en parallèle. Or, comme vu avec la 1ère possibilité, ce n’est pas possible avec xUnit : la parallélisation se fait par collection ou fichier de test, pas par test. C’est un peu pareil avec NUnit d’ailleurs.
C’est un peu dommage : on a la possibilité de lancer tous les tests en parallèle mais les 2 plus gros frameworks de tests en .Net, xUnit et NUnit, ne le permettent pas vraiment. Heureusement il existe une autre alternative qu’on explorera lors d’un prochain article !
Conclusion
On vient de voir 3 possibilités permettant d’attenuer le principal problème de Testcontainers, à savoir le coût de lancement. Choisir laquelle de ces solutions est la meilleure pour vous dépendra essentiellement de votre contexte et du scope de vos tests. Il est en revanche crucial d’y réfléchir à cause des race conditions vues précédemment mais aussi des améliorations possibles de temps d’exécution des tests que ce soit en local ou sur l’usine de build.
Il faut aussi savoir prendre de la distance quant aux performances, peut-être que prendre 1 minute de plus pour lancer tous les tests n’est pas très grave si les tests sont mieux isolés. Là encore, ça dépend de votre contexte.
Quels tests voulez-vous faire tourner et à quel moment ? Dans notre équipe, on fait tout tourner en local ET sur l’usine de build. Mais peut-être que ce n’est pas possible chez vous pour diverses raisons. Ce n’est d’ailleurs peut-être pas indispensable ! Il est possible de laisser les tests d’intégration tourner sur un environnement dédié, par exemple.
Toujours est-il qu’en 2026 on a maintenant les moyens de réduire la frontière entre tests unitaires, tests d’acceptance et tests d’intégration : s’il est possible et peu coûteux d’inclure les requêtes SQL ou les requêtes de cache dans un test d’acceptance, pourquoi s’en priver ? D’autant plus que ce que l’on a vu aujourd’hui n’est qu’un début. Dans l’article suivant de la série, je vous parlerai d’optimisations pour lancer les tests, que ce soit au niveau du container PostgreSQL ou de l’API.
Software developer since 2000, I try to make the right things right. I usually work with .Net (C#) and Azure, mostly because the ecosystem is really friendly and helps me focus on the right things.
I try to avoid unnecessary (a.k.a. accidental) complexity and in general everything that gets in the way of solving the essential complexity induced by the business needs.
This is why I favor a test-first approach to focus on the problem space and ask questions to business experts before even coding the feature.